Construire son premier assistant RAG avec LangChain
Sommaire
Un modèle de langage ne connaît que ce qu'il a vu pendant son entraînement. Il ignore vos rapports internes, vos jeux de données ou la documentation de votre projet — et quand on l'interroge dessus, il peut inventer une réponse avec aplomb.
Le RAG (Retrieval-Augmented Generation) comble ce manque. Avant de répondre, l'assistant va chercher les passages utiles dans vos propres documents, puis s'en sert comme contexte pour construire sa réponse. Cet article présente les quatre briques d'un pipeline RAG et une première implémentation en Python.
Pourquoi le RAG ?
Réentraîner un modèle sur vos données coûte cher et devient vite obsolète. Avec le RAG, vos documents restent séparés du modèle : il suffit de les mettre à jour pour que l'assistant en tienne compte dès la question suivante. Autre avantage, la traçabilité — chaque réponse peut indiquer les passages dont elle est tirée, ce qui la rend vérifiable.
À retenir
Le RAG ne rend pas le modèle plus intelligent : il lui donne le bon contexte au bon moment. La qualité des réponses dépend d'abord de la qualité de vos documents et de leur découpage.
Les quatre étapes d'un pipeline RAG
Quel que soit l'outil, un système RAG a deux phases. L'indexation a lieu une fois, quand les documents sont ajoutés. L'interrogation a lieu à chaque question.
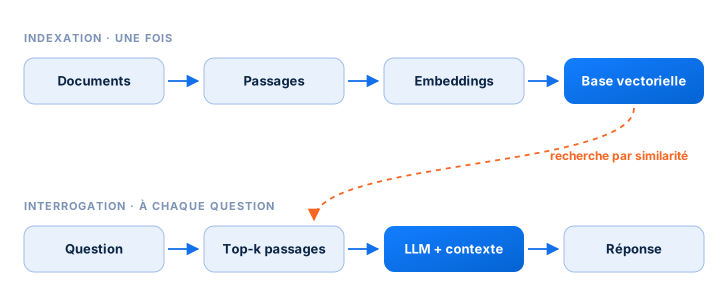 Fig. 1. Un pipeline RAG. Les documents sont indexés une fois ; chaque question récupère les passages les plus proches avant la génération.
- Charger — lire les documents sources (PDF, pages web, fichiers texte).
- Découper — les diviser en passages courts, qui se chevauchent légèrement pour ne pas perdre le contexte aux frontières.
- Indexer — transformer chaque passage en vecteur (un embedding) et le ranger dans une base vectorielle.
- Interroger — à chaque question, retrouver les passages les plus proches et les transmettre au modèle avec la question.
Choisir la taille des passages
Des passages trop longs diluent l'information utile ; trop courts, ils perdent leur contexte. Un point de départ courant est un chunk_size de quelques centaines à mille caractères, avec un chunk_overlap de 10 à 20 % — puis on ajuste en testant sur de vraies questions.
Mesurer la similarité
Pour trouver les passages les plus proches d'une question, les deux sont transformés en vecteurs puis comparés. La mesure la plus courante est la similarité cosinus : elle regarde l'angle entre les deux vecteurs plutôt que leur longueur.
Similarité cosinus entre le vecteur de la question q et celui d'un passage d.
Un premier pipeline en Python
Voici le squelette des quatre étapes avec LangChain. Le modèle d'embeddings est laissé au choix : un modèle open source en local ou une API.
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import FAISS

# 1. Charger
docs = PyPDFLoader("guide_nutrition.pdf").load()

# 2. Découper
splitter = RecursiveCharacterTextSplitter(chunk_size=800, chunk_overlap=100)
chunks = splitter.split_documents(docs)

# 3. Indexer
embeddings = ...  # le modèle d'embeddings de votre choix
vectorstore = FAISS.from_documents(chunks, embeddings)

# 4. Interroger
retriever = vectorstore.as_retriever(search_kwargs=dict(k=4))
passages = retriever.invoke("Quels aliments locaux sont riches en fer ?")
Le retriever renvoie les quatre passages les plus pertinents pour la question posée. Il ne reste plus qu'à les insérer dans le prompt envoyé au modèle de langage, avec la consigne de répondre uniquement à partir de ce contexte — et de le dire quand la réponse n'y est pas.
Pour aller plus loin
Une fois ce socle en place, les vrais gains viennent généralement de trois leviers :
- Évaluer les réponses sur un jeu de questions test, pour mesurer chaque changement.
- Essayer différents modèles d'embeddings, en particulier pour le français et les langues locales.
- Combiner la recherche vectorielle avec une recherche par mots-clés pour les noms, codes et sigles.
Références
- Lewis, P., Perez, E., Piktus, A., et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. arXiv:2005.11401
- Johnson, J., Douze, M., & Jégou, H. (2017). Billion-scale similarity search with GPUs. arXiv:1702.08734
- Documentation LangChain. python.langchain.com
Citation
Pour citer cet article :
Équipe DAH Labs. (septembre 2026). Construire son premier assistant RAG avec LangChain. DAH Labs Blog. https://dah-projects-and-innovations.github.io/dah-labs-site/fr/blog/rag-langchain/
Ou
@article{dahlabs2026raglangchain,
  title   = "Construire son premier assistant RAG avec LangChain",
  author  = "Équipe DAH Labs",
  journal = "DAH Labs Blog",
  year    = "2026",
  url     = "https://dah-projects-and-innovations.github.io/dah-labs-site/fr/blog/rag-langchain/"
}
Articles écrits par les membres de DAH Labs, le centre d'innovation et d'incubation de Data Afrique Hub.